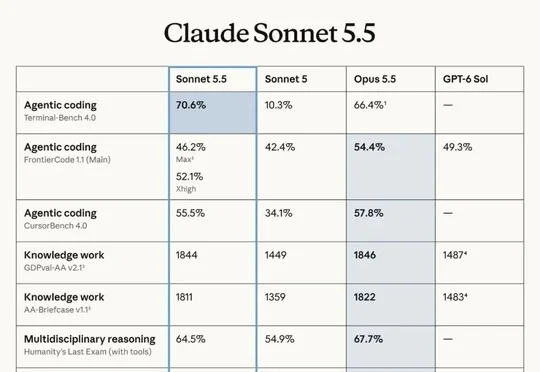
刚刚,性价比之王Sonnet 5.5发布!
刚刚,性价比之王Sonnet 5.5发布!Anthropic发布Claude Sonnet 5.5,运行速度较前代提升30%、单任务成本最高降低30%,以一半的标价在多项基准测试中接近或反超大杯Opus 5.5,凭借代码、视觉理解和办公等能力成为新一代性价比之王。
来自主题: AI资讯
9571 点击 2026-09-29 10:12

 搜索
Anthropic发布Claude Sonnet 5.5,运行速度较前代提升30%、单任务成本最高降低30%,以一半的标价在多项基准测试中接近或反超大杯Opus 5.5,凭借代码、视觉理解和办公等能力成为新一代性价比之王。
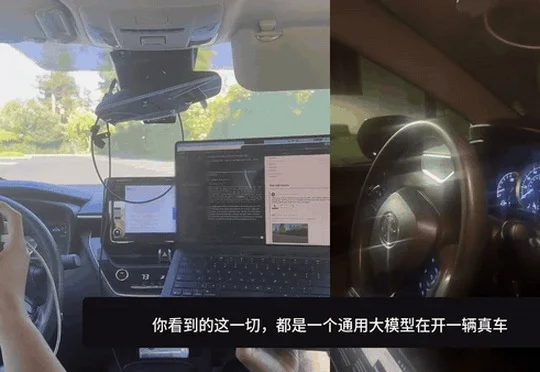
硅谷DrivingBench测试中,从未专门学过开车的通用大模型GPT-6 Astra操控改装丰田卡罗拉以5分22秒通过锥桶摆出的科目二考场,成为全场唯一通关的大模型,而Claude Fable 5.1、Grok 4.6和GPT-5.6 Sol均未通过。
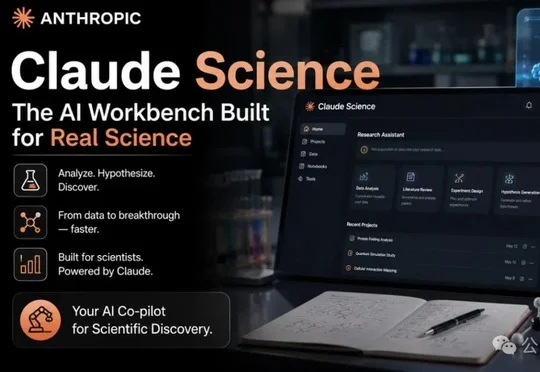
Anthropic将开发者工具Workbench更名为Playground,推出基于Messages API的可视化产品,让不会写代码的普通用户也能通过图形界面调节Claude 3.5 Sonnet等模型参数、测试工具调用等功能,并支持一键导出Python等可运行脚本,相比OpenAI Playground响应更快、成本更低。
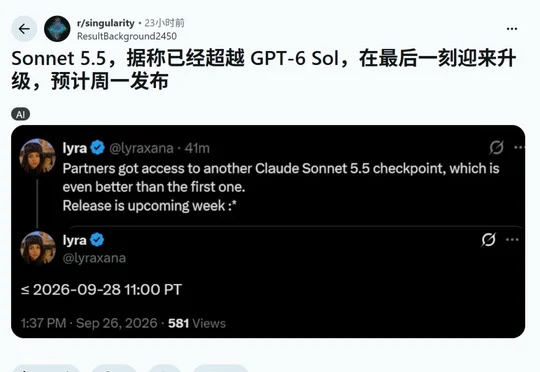
Claude Sonnet 5.5在Claude Code中被抓包偷跑并开启灰度测试,多位开发者实测显示其性能碾压GPT-6 Sol并在编码与Agent能力上直逼GPT-6 Astra,同时定价低至百万Token输入2美元,Anthropic意在OpenAI DevDay前截杀对手。
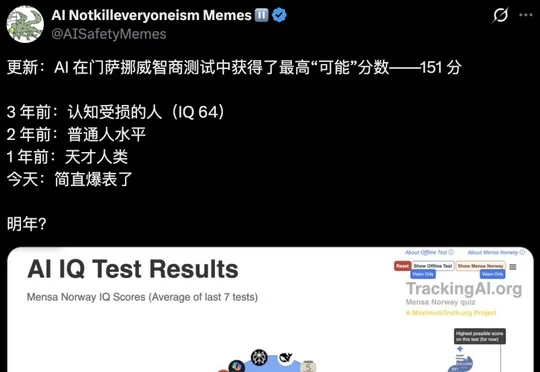
TrackingAI榜单显示,Claude Fable 5.1和GPT-6 Astra在门萨挪威智商测试中以151分满分登顶,碾压99.97%的人类,AI仅用两年半便从64分飙升至满分。
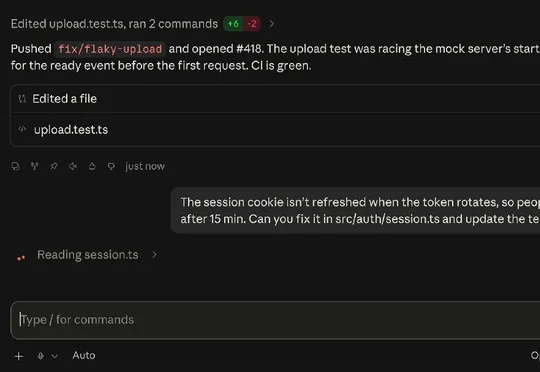
Anthropic为Claude Code新增"收尾额度"(Wrap-Up Allowance)功能,撞上5小时用量上限时不再一刀切断,而是从周限额中扣除固定额度让当前步骤做完再停,Pro用户每周仅可使用一次。
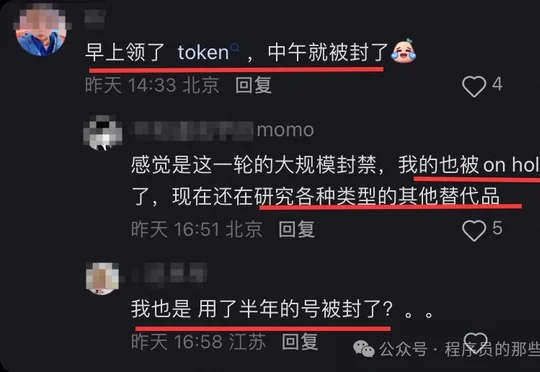
Claude推出绑定GitHub即可领取限时云端额度的福利后,多名通过非官方渠道使用的国内用户在领取后不久因违反支持地区政策被封号,被网友调侃为"A社钓鱼执法"。
美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
前OpenAI研究员、TypeSafe CEO Diogo Almeida在播客访谈中批评Codex和Claude Code仍停留在AI辅助人类的阶段,称"Jev出现前的AI世界是个悲剧",并推出采用RLCD训练的System 1模型Jev,旨在让代码直接可靠调用AI判断,实现每美元智能最优。
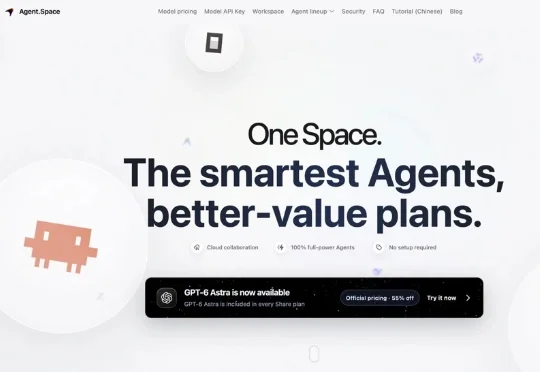
Agent Space作为汇集顶级Agent的云端工作空间,支持Claude Code、CodeX、OpenCode等本地工具接入云端运行,并可直接使用Opus 5.5、GPT-6 Sol、GPT-6 Luna及GPT-6 Astra等最新模型,其订阅额度还能同步接入本地Agent使用,降低了高价AI模型的使用门槛。